Tokens zijn de stukjes tekst waarin een AI-taalmodel jouw invoer en zijn eigen antwoord opknipt. Een token is soms een heel woord, soms een deel van een woord of een leesteken. Een groot taalmodel, een LLM, leest en schrijft niet in woorden, maar in tokens.
Het opknippen heet tokenisatie en volgt een vaste woordenlijst per model. Voor Engelse tekst geldt een vuistregel van ongeveer vier tekens of driekwart woord per token; voor Nederlands bestaat zo’n vaste omrekening niet.
Tokens tel je met een tokenizer of een telfunctie van de aanbieder, en ze komen in twee soorten: input- en outputtokens. Het contextvenster van een model is uitgedrukt in tokens, en AI-aanbieders rekenen hun API per token af. Afbeeldingen en pdf’s worden eveneens omgezet in tokens, en wie dat weet, gaat er zuiniger mee om.
Wat is een token bij AI?
Een token bij AI is de eenheid tekst waarmee een taalmodel rekent. Elk token krijgt een vast nummer uit de woordenlijst van het model, en het model verwerkt die reeks nummers in plaats van de letters zelf.
Korte, veelvoorkomende woorden zoals “de” of “het” zijn meestal één token. Een lang of zeldzaam woord valt uiteen in meerdere tokens. Spaties en leestekens tellen ook mee, soms als deel van een woordtoken en soms als los token.
Het woord token heeft buiten AI andere betekenissen, zoals een crypto-token of een inlogtoken. In de context van ChatGPT, Claude en Gemini gaat het om deze tekstdelen.
Hoe splitst een taalmodel tekst op in tokens?
Een taalmodel splitst tekst op in tokens met een tokenizer: een programma dat de tekst vergelijkt met een vaste woordenlijst en hem opdeelt in de langste stukken die in die lijst voorkomen. De meeste moderne tokenizers zijn gebaseerd op byte pair encoding.
Byte pair encoding begint bij losse tekens en voegt de tekenparen die het vaakst samen voorkomen stap voor stap samen tot nieuwe tokens. Zo belanden veelgebruikte woorden als geheel in de woordenlijst, en worden zeldzame woorden opgebouwd uit bekende stukjes. Een lange Nederlandse samenstelling zoals “arbeidsongeschiktheidsverzekering” valt daardoor in meerdere tokens uiteen.
Tokenizers verschillen per aanbieder en soms per modelgeneratie. Anthropic meldt bijvoorbeeld dat zijn nieuwere tokenizer voor dezelfde tekst ongeveer 30 procent meer tokens oplevert dan de vorige. Een taalmodel voorspelt vervolgens token voor token wat er volgt, en dat verklaart waarom een antwoord stukje voor stukje op je scherm verschijnt.
Hoeveel woorden is een token?
Een token is in het Engels gemiddeld ongeveer driekwart woord, maar die verhouding verschilt per taal en per model. Er is daarom geen omrekening die voor elke tekst klopt.
Hoeveel tokens is Engelse tekst?
Engelse tekst levert volgens OpenAI ongeveer één token per vier tekens op, wat neerkomt op 100 tokens per 75 woorden. Een Engelse tekst van 1.500 woorden telt dus rond de 2.000 tokens.
OpenAI noemt deze getallen uitdrukkelijk een schatting. Code, tabellen en tekst met veel cijfers of hoofdletters wijken ervan af.
Hoeveel tokens is Nederlandse tekst?
Voor Nederlandse tekst publiceren OpenAI en Anthropic geen vuistregel. OpenAI geeft zijn verhouding alleen voor Engels en schrijft dat andere talen een andere verhouding tussen tekens, woorden en tokens hebben.
De oorzaak zit in de woordenlijst van de tokenizer. Nederlandse samenstellingen en vervoegingen komen minder vaak in die lijst voor als geheel, en worden daarom vaker in meerdere tokens opgeknipt. Wie voor een Nederlandse tekst een exact aantal nodig heeft, telt dat met de tokenizer van het model zelf.
Hoe tel je tokens voordat je een prompt verstuurt?
Tokens tel je vooraf met de tokenizer of de telfunctie van de aanbieder van het model dat je gebruikt. Een telling met de tokenizer van een ander model geeft een afwijkend getal.
OpenAI biedt een online Tokenizer en de programmeerbibliotheek tiktoken. Anthropic biedt in zijn API een gratis telfunctie die het aantal inputtokens van een volledig bericht telt, inclusief systeemprompt, afbeeldingen en pdf’s. Volgens Anthropic is die telling een schatting die in sommige gevallen een klein beetje afwijkt van het werkelijke verbruik.
In een chatinterface zoals ChatGPT of claude.ai zie je geen tokentelling per bericht. Daar merk je het tokenverbruik pas aan de gebruikslimiet van je abonnement.
Wat is het verschil tussen input- en outputtokens?
Inputtokens zijn de tokens die je naar het model stuurt, outputtokens zijn de tokens die het model genereert. Je vraag, je bijlagen en de eerdere berichten in het gesprek tellen als input, het antwoord telt als output.
Outputtokens zijn bij de grote aanbieders duurder dan inputtokens, omdat het model outputtokens één voor één genereert, terwijl het de input in één keer verwerkt. Redeneermodellen voegen daar een derde stroom aan toe: tokens voor de tussenstappen die je niet als antwoordtekst ziet. Volgens OpenAI tellen die redeneertokens mee als output en worden ze ook zo gefactureerd.
Wat heeft het contextvenster met tokens te maken?
Het contextvenster is het maximale aantal tokens dat een model in één keer verwerkt, en dat aantal omvat zowel de input als de output. Anthropic omschrijft een contextvenster van 200.000 tokens als ongeveer 500 pagina’s tekst.
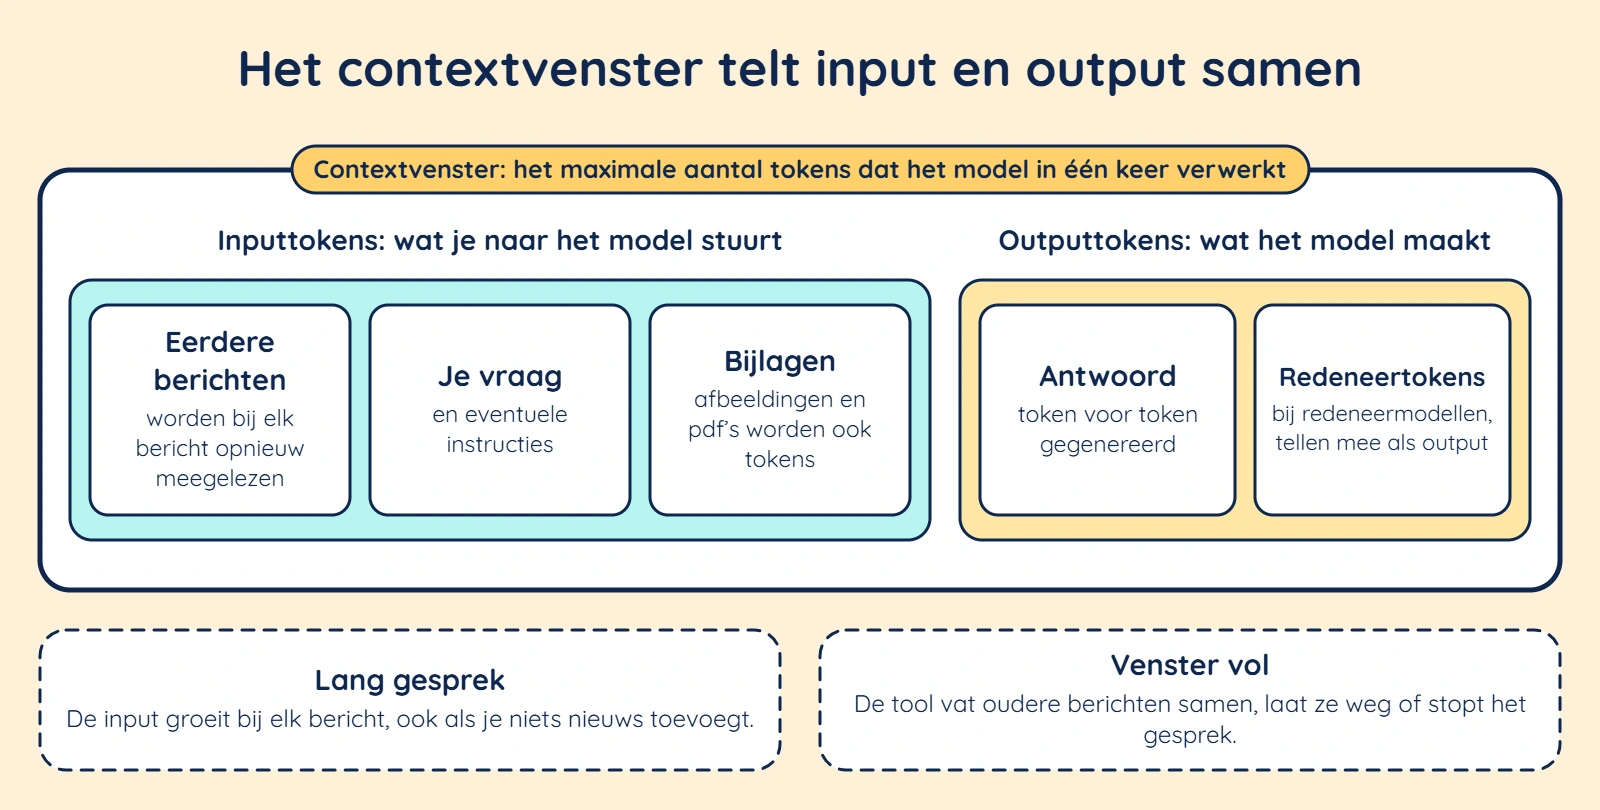
In een lang gesprek groeit de input bij elk bericht, omdat het model de eerdere berichten opnieuw meeleest. Raakt het venster vol, dan vat de tool oudere berichten samen, laat hij ze weg of stopt het gesprek. Daarom loont het om context aan een LLM beknopt en gericht mee te geven, in plaats van alles in één gesprek te blijven stapelen.
Waarom rekenen AI-aanbieders per token af?
AI-aanbieders rekenen per token af omdat de rekenkracht die een model gebruikt, meegroeit met het aantal tokens dat het verwerkt en genereert. Een prijs per miljoen inputtokens en per miljoen outputtokens is daardoor de meest directe weergave van wat een aanvraag kost.
Die afrekening geldt voor de API. Bij een abonnement betaal je een vast bedrag per maand en krijg je een gebruikslimiet, zonder tokenteller. Wie de Claude kosten van een abonnement en van de API naast elkaar zet, ziet dat het verschil vooral zit in hoe voorspelbaar je verbruik is.
Bij het ontwikkelen van een nieuwe workflow op de Claude API merkte ik dat de kosten vooral in de testfase oplopen. Daar itereer je vaker dan in productie, en elke testronde telt in tokens.
Tellen afbeeldingen en bestanden ook als tokens?
Ja, afbeeldingen en bestanden tellen ook als tokens, want een model zet ze om in een reeks tokens voordat het ze verwerkt. Claude deelt een afbeelding op in blokjes van 28 bij 28 pixels; een afbeelding van 1.000 bij 1.000 pixels kost daardoor 1.296 tokens.
Bij Claude telt een pdf dubbel mee. Anthropic zet elke pagina om in een afbeelding en levert de tekst van die pagina ernaast aan. Volgens Anthropic kost de tekst van een pagina doorgaans 1.500 tot 3.000 tokens, plus de tokens voor het beeld van die pagina.
Hoe ga je zuinig om met tokens in je werk?
Zuinig omgaan met tokens begint bij korte, gerichte invoer: deel alleen de pagina’s of passages die nodig zijn, en start een nieuw gesprek zodra het onderwerp wisselt. Zo blijft er in het contextvenster ruimte voor wat ertoe doet.
Vraag daarnaast om een kort antwoord als een lang antwoord geen waarde toevoegt, want outputtokens zijn de duurste. Voor de vraag hoeveel tokens bij Claude Pro beschikbaar zijn, telt een andere logica: daar bepaalt een gebruikslimiet per sessie hoeveel ruimte je hebt.
Wie begrijpt hoe tokens, contextvensters en gebruikslimieten samenhangen, maakt betere keuzes over welke tool en welk abonnement bij een taak passen. Die kennis vormt de basis van de AI-geletterdheid cursus. Daarin leer je hoe taalmodellen werken, waar ze fouten maken en welke afspraken een team nodig heeft voor verantwoord gebruik.