Een neuraal netwerk is de rekenstructuur onder de meeste moderne AI, waaronder ChatGPT, Claude en spraakherkenning. Binnen kunstmatige intelligentie vormen neurale netwerken de bouwsteen waarmee systemen patronen leren uit voorbeelden in plaats van vaste regels te volgen.
Een neuraal netwerk bestaat uit neuronen in lagen, verbonden door gewichten die bepalen hoe zwaar elk signaal meetelt. Invoer gaat laag voor laag door het netwerk, totdat er aan het eind een uitkomst staat.
Leren gebeurt tijdens het trainen: het netwerk doet een voorspelling, meet de fout en stelt met backpropagation de gewichten bij. Die cyclus herhaalt zich tot de voorspellingen goed genoeg zijn.
Een neuraal netwerk herkent patronen, maar bevat geen kennis of begrip. Juist dat verschil bepaalt hoe je op kantoor met de output van AI-tools omgaat.
Wat is een neuraal netwerk?
Een neuraal netwerk is een rekenmodel dat leert patronen te herkennen door veel voorbeelden te verwerken, en daarmee voorspellingen doet over nieuwe invoer. De volledige naam is kunstmatig neuraal netwerk, omdat de opbouw losjes is geïnspireerd op zenuwcellen in de hersenen.
Een spamfilter die op basis van veel gelabelde e-mails nieuwe berichten beoordeelt, is een eenvoudig voorbeeld. Een groot taalmodel is hetzelfde principe op een veel grotere schaal.
Waaruit bestaat een neuraal netwerk?
Een neuraal netwerk bestaat uit drie onderdelen: neuronen, de gewichten tussen die neuronen en de lagen waarin de neuronen zijn geordend.
Wat doet een neuron in een neuraal netwerk?
Een neuron in een neuraal netwerk is een kleine rekeneenheid die getallen ontvangt, die getallen weegt en optelt en de uitkomst doorgeeft aan de volgende laag. Een activatiefunctie bepaalt daarbij hoe sterk het neuron reageert op de opgetelde invoer.
Dankzij die activatiefunctie leert een netwerk ook verbanden die niet recht evenredig lopen, zoals de combinatie van woorden die samen op spam wijzen.
Wat zijn gewichten in een neuraal netwerk?
Gewichten in een neuraal netwerk zijn de getallen die het netwerk tijdens het trainen bijstelt. Een gewicht bepaalt hoe zwaar een binnenkomend signaal meetelt; de bias is een vast startgetal per neuron dat de drempel verschuift waarop het neuron reageert.
Een groot taalmodel bevat miljarden van zulke getallen. Samen vormen ze alles wat het model uit zijn training heeft vastgelegd.
Uit welke lagen bestaat een neuraal netwerk?
Een neuraal netwerk bestaat uit drie soorten lagen: de invoerlaag ontvangt de gegevens, de verborgen lagen bewerken die gegevens en de uitvoerlaag geeft de uitkomst. Bij een spamfilter krijgt de invoerlaag de woorden van een e-mail binnen en geeft de uitvoerlaag één getal: de kans dat het bericht spam is.
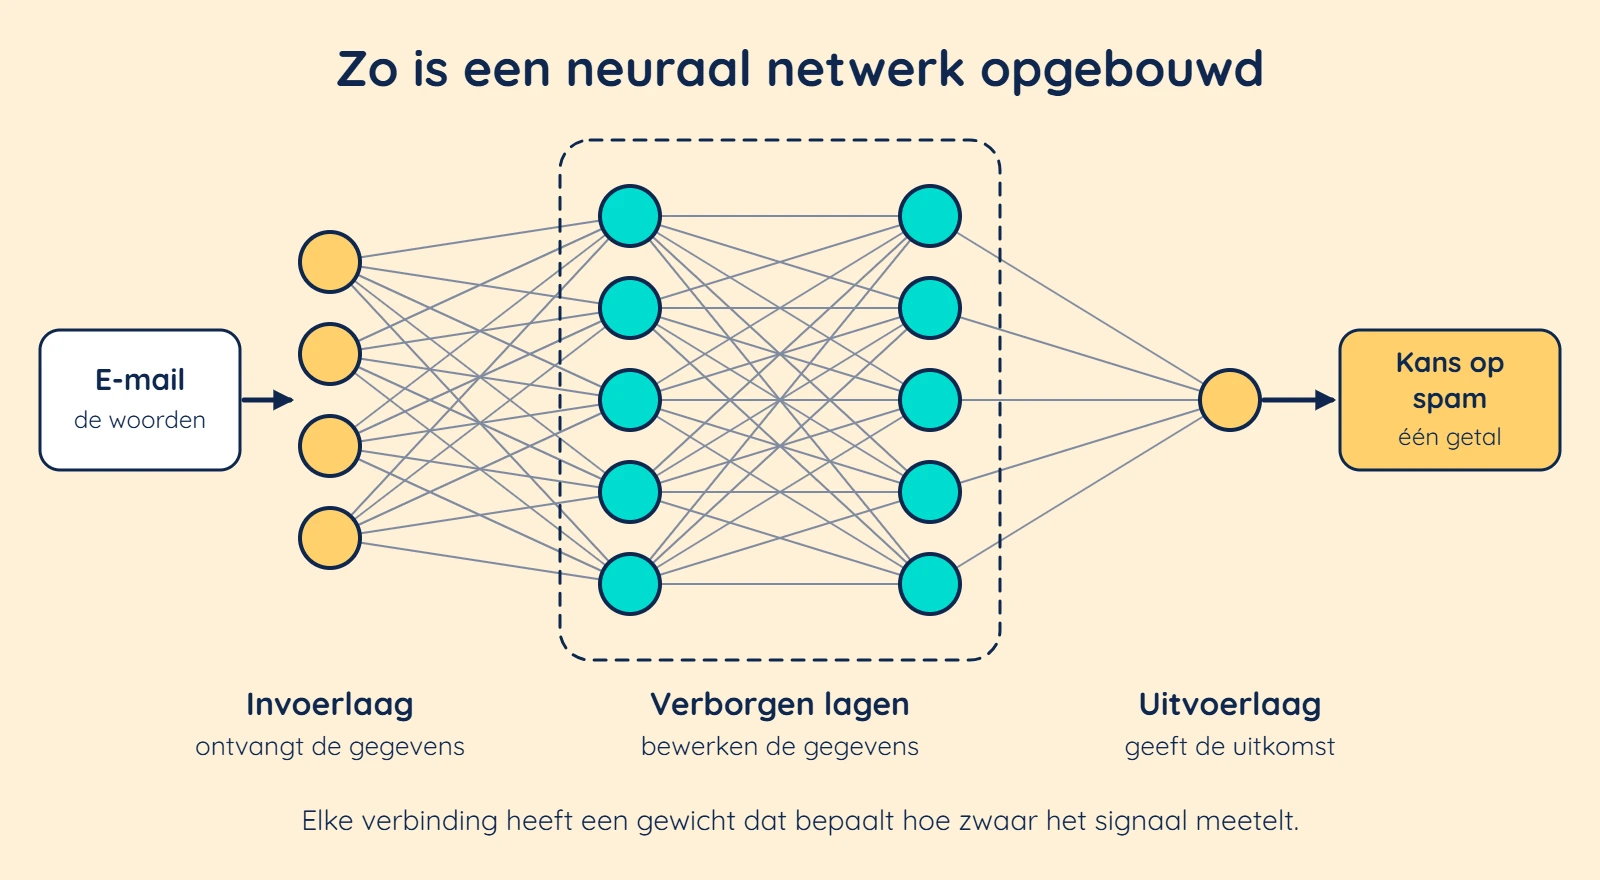
Een netwerk met veel verborgen lagen heet een diep netwerk, en daar komt de term deep learning vandaan.
Hoe verwerkt een neuraal netwerk informatie?
Een neuraal netwerk verwerkt informatie laag voor laag, in één richting van invoer naar uitvoer; die stap heet de voorwaartse doorgifte. Elk neuron ontvangt de signalen van de vorige laag, vermenigvuldigt ze met de gewichten, telt ze op en geeft het resultaat door.
Na de laatste laag staat er een uitkomst, zoals de kans dat een e-mail spam is of het meest waarschijnlijke volgende woord in een zin. Tijdens gebruik verandert er niets aan het netwerk: de gewichten liggen na de training vast en nieuwe invoer loopt alleen door de bestaande rekenstappen.
Hoe leert een neuraal netwerk?
Een neuraal netwerk leert door zijn gewichten stap voor stap bij te stellen, totdat de voorspellingen zo weinig mogelijk afwijken van de juiste antwoorden. Drie begrippen beschrijven dat leerproces: trainen, backpropagation en overfitting.
Wat gebeurt er tijdens het trainen van een neuraal netwerk?
Tijdens het trainen van een neuraal netwerk verwerkt het model trainingsdata waarvan het juiste antwoord bekend is, en vergelijkt het elke voorspelling met dat antwoord. Een verliesfunctie drukt het verschil uit in één getal: hoe groter dat getal, hoe verder het netwerk ernaast zat.
Trainen is het herhaald verlagen van dat getal over heel veel rondes. De training stopt wanneer dat getal nauwelijks nog daalt of wanneer de score op testdata verslechtert.
Wat is backpropagation?
Backpropagation is de rekenmethode waarmee een neuraal netwerk bepaalt welk gewicht hoeveel heeft bijgedragen aan een fout. De fout wordt van de uitvoerlaag terug door het netwerk gerekend, laag voor laag, en elk gewicht schuift een klein stukje in de richting die de fout verkleint.
Die richting heet de gradiënt. David Rumelhart, Geoffrey Hinton en Ronald Williams beschreven de methode in 1986 in Nature, en moderne neurale netwerken worden er nog steeds mee getraind.
Wat is overfitting?
Overfitting betekent dat een neuraal netwerk zijn trainingsdata uit het hoofd leert in plaats van het onderliggende patroon. Zo’n netwerk scoort uitstekend op voorbeelden die het al kent en slecht op nieuwe gevallen.
Ontwikkelaars controleren daarom met testdata: voorbeelden die het netwerk tijdens het trainen nooit heeft verwerkt.
Lijkt een neuraal netwerk op het menselijk brein?
Nee, een neuraal netwerk lijkt alleen in de basisgedachte op het menselijk brein: veel eenvoudige eenheden die signalen doorgeven via verbindingen van wisselende sterkte. In het brein heten die verbindingen synapsen, in een neuraal netwerk zijn het gewichten.
Onderzoek uit 2009 telde in het brein van volwassen mannen gemiddeld zo’n 86 miljard zenuwcellen, die chemisch en elektrisch werken en zich voortdurend aanpassen. Een kunstmatig neuron is een rekensom, geen zenuwcel.
De vergelijking met het brein is een inspiratiebron uit de begintijd van het vakgebied, geen beschrijving van hoe een AI-model werkt.
Welke soorten neurale netwerken zijn er?
Er zijn vier soorten neurale netwerken die in de praktijk het vaakst voorkomen, elk gebouwd voor een ander type gegevens:
- Feedforward-netwerken: de eenvoudigste vorm, waarin signalen in één richting van invoer naar uitvoer lopen, bijvoorbeeld voor een risicoscore.
- Convolutionele netwerken: gespecialiseerd in beeld, omdat ze kleine delen van een afbeelding afzonderlijk analyseren, bijvoorbeeld bij het uitlezen van scans.
- Recurrente netwerken: gebouwd voor reeksen zoals spraak en tijdreeksen, omdat ze informatie van de vorige stap meenemen naar de volgende.
- Transformers: gebouwd voor taal, en beschreven door Ashish Vaswani en collega’s in 2017 in het artikel Attention Is All You Need.
Een transformer weegt alle woorden in een tekst tegelijk ten opzichte van elkaar, in plaats van één voor één. Op die bouw draait vrijwel elk groot taalmodel, ook wel LLM genoemd; de T in GPT, het model achter ChatGPT, staat voor transformer.
Wat kan een neuraal netwerk niet?
Een neuraal netwerk bevat geen kennis en geen begrip, alleen getallen die patronen uit de trainingsdata vastleggen. Daardoor geeft een taalmodel een antwoord dat klinkt als een feit, terwijl het alleen het meest waarschijnlijke vervolg is.
De uitkomst is bovendien een black box: de miljarden gewichten laten niet zien waarom het netwerk tot een antwoord kwam. Voor wie AI-output gebruikt in een advies, een akte of een jaarrekening, is het netwerk daarom nooit de bron.
De bron is het dossier, de wet of de cijfers die je zelf controleert.
Wat is het verschil tussen een neuraal netwerk en deep learning?
Een neuraal netwerk is de bouwsteen, deep learning is de werkwijze waarbij je zulke netwerken met veel lagen traint op grote hoeveelheden data. Een netwerk met één of twee verborgen lagen is een neuraal netwerk, maar nog geen deep learning.
Pas bij veel opeenvolgende lagen spreek je van deep learning, waarin elke laag een abstracter patroon herkent dan de vorige.
Is een neuraal netwerk hetzelfde als AI?
Nee, een neuraal netwerk is niet hetzelfde als AI, omdat AI het hele vakgebied is en een neuraal netwerk één techniek daarbinnen. Neurale netwerken vallen onder machine learning, de tak van AI waarin systemen leren van data.
Daarnaast bestaan er AI-systemen zonder neuraal netwerk, zoals regelgebaseerde systemen die vaste als-dan-regels volgen.
Is ChatGPT een neuraal netwerk?
Ja, ChatGPT draait op een neuraal netwerk, omdat de GPT-modellen van OpenAI grote transformer-netwerken zijn met miljarden gewichten. ChatGPT zelf is de dienst eromheen, met de chatinterface, de geheugenfunctie en de koppelingen met zoeken en bestanden.
Binnen die dienst voorspelt het taalmodel, een neuraal netwerk, de tekst van elk antwoord.
Slaat een neuraal netwerk je gegevens op?
Nee, een neuraal netwerk slaat je gegevens niet op tijdens gebruik, omdat de gewichten na de training vastliggen en je invoer er alleen doorheen loopt. Wat er met je invoer gebeurt, bepaalt de aanbieder van de dienst.
De voorwaarden en instellingen van die dienst bepalen of gesprekken worden bewaard en gebruikt om toekomstige modellen te trainen. Voor vertrouwelijke cliëntgegevens is dat beleid de vraag die telt, niet de werking van het netwerk.
Sinds wanneer bestaan neurale netwerken?
Neurale netwerken gaan terug tot 1943, toen Warren McCulloch en Walter Pitts een wiskundig model van een zenuwcel publiceerden. In 1958 beschreef Frank Rosenblatt de perceptron, een netwerk dat zijn gewichten zelf aanpaste op basis van voorbeelden.
Backpropagation maakte in 1986 het trainen van netwerken met meerdere lagen praktisch. In 2024 kregen John Hopfield en Geoffrey Hinton de Nobelprijs voor Natuurkunde voor ontdekkingen die machine learning met kunstmatige neurale netwerken mogelijk maken.
Hoe leer je verantwoord werken met AI-tools die op neurale netwerken draaien?
Verantwoord werken met AI-tools die op neurale netwerken draaien leer je door de werking te koppelen aan controle. Neuronen en gewichten leggen patronen vast, geen feiten, dus toets je elke uitkomst. Voor die toetsing reken je geen backpropagation uit en train je zelf geen netwerk.
LearnLLM biedt die basis in een AI-geletterdheid training met praktijkopdrachten op je eigen werk, afgesloten met een certificaat van afronding.